はじめに
ビシバシチャンプ…。
ふと思いつきまして Netlify で使える Lambda なサービス、Netlify Functions を用いて参照系検索 API を作成してみました。無料枠での挑戦です。
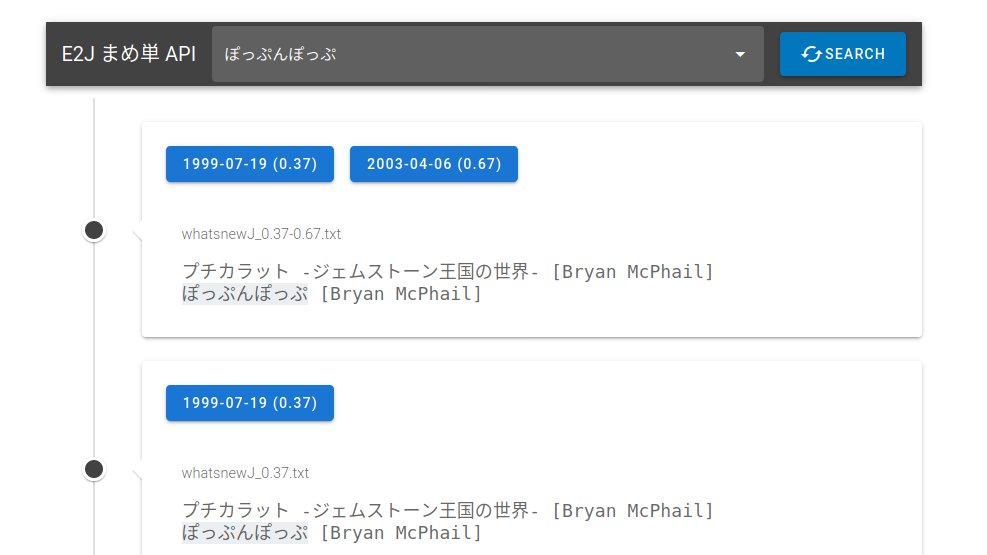
この作業中にいくつか Netlify の知見がたまりましたので、ここに掲載したいと思います。全ソースコードへのリンクを文末につけています。何かの参考になればと思います。
Netlify Functions
Netlify Functions は静的ファイルホスティングサービス Netlify が提供する、くだけて言えば Amazon AWS Lambda に対するプログラムの自動デプロイの仕組みで、Netlify のアカウントにて(クレジットカード登録が必要な AWS アカウントなしに)Lambda を利用することができます。
無料枠でも比較的制限が少なく、現在のスペックは次のようになります。
- us-east-1 AWS Lambda region
- 1024MB of memory
- 10 second execution limit
自分が注目したのは 1024MB(1GB) ものメモリーがアサインされる点で、これを参照データーベースとして使えないかと思い立ったのが事の始まりでした。
Netlify からは DynamoDB などのデーターストアは提供されていませんので、JavaScript のオブジェクト(JSON) を key-value ストアにして全てメモリーで処理させる作戦です。
いったん JSON がメモリーにロードさえできてしまえば連想配列の検索処理時間はないに等しいですので、鍵は Lambda 初期起動が実行制限となっている 10 second execution limit(10秒)以内に巨大な辞書を読み終えられるかどうかということになります。
今回実装した検索 API について
530個、総容量約 8MB に及ぶ日本語テキストファイルを形態素解析し全文検索する API です。
対象のテキストファイルは専門用語がたくさん書かれたメタ情報のない自由形式となっており、改行の位置などを含めて機械にはコンピューターには処理しにくい形式です。具体的にはあるフリーソフトウェアの 20年分のリリースノート日本語訳を対象としています。
検索リクエストの都度、Lambda でテキストファイルの改行処理や形態素解析をしながら検索結果を返却するのは処理が厳しいため、このあたりの部分は Github Action で上で動作するバッチにしています。
参考までに手順としては、
- 全テキストファイルをパースし必要な部分では改行を次の行に接続するなどの正規化後、
- これもバッチ中に生成した専門用語を辞書登録した MeCab で形態素解析
- 名詞やサ変動詞などを抽出し「検索ワード」(12000語程度)としストップワードなどを除外(10000語程度)
- 「検索ワード」でテキストファイルを再検索 grep や awk や Python を使い「検索結果」として出現した前後の行を加え
{ "検索ワード" : [検索結果], }な巨大 JSON を生成
この手順で生成されたキーバリューの JSON は 100MB以上、.bz2 圧縮で 10MB という大きさになります。 また、リリースノートテキストファイルが追加される都度、Github Action の push フックからスクリプトが動作し辞書の再生成が行われます。
スクリプトの一部
######################################################################
## 検索ワード辞書作成
######################################################################

# mecab で英単語・記号を除外する名詞(一般、固有、サ変接続)を抽出する
SEARCH_DIC_TMP_WORDS=$(mktemp)
find ${WHATSNEW_DIR} -maxdepth 1 -name ${WHATSNEW_NAME} | while read path
do
    # テキストファイルで、日本語改行後の行頭にスペースがある場合は
    # 連続する文章として連結する。英単語の場合は連結しない。
    SEARCH_DIC_TMP_REGEX=$(mktemp)
    sed -z -r 's/([亜-熙ぁ-んァ-ヶー])\n[ | ]*([亜-熙ぁ-んァ-ヶー]+)/\1\2/g' ${path} > ${SEARCH_DIC_TMP_REGEX}
    # MeCab による形態素解析
    mecab ${SEARCH_DIC_TMP_REGEX} \
        -u ${MECAB_DIC} \
        | egrep -v '^[!-~]+.+\*$' \
        | egrep '^.+[[:space:]]名詞,(一般|固有|サ変接続)' \
        | awk '{ print $1 }' \
        | sort \
        | uniq \
        >> ${SEARCH_DIC_TMP_WORDS}
    rm ${SEARCH_DIC_TMP_REGEX}
done
次のリンクから実際に API が動いている様子をみることができます。画面は API のテスト用に Vue(Vuetify) で暫定的につくったもので Github Pages においていますが、裏側では Netlify Functions が呼ばれています。
https://h1romas4.github.io/e2j-api-web/
継続でアクセスがない場合は Lambda が寝てしまいますので 1度目の検索に数秒かかりますが、2回目以降の検索は高速に動くハズです。(なんといっても Lambda 上の検索処理としては key-value 引き return dictionary[query] しているだけですので…)
「あ」とか「い」とか適当に日本語を入れていただけるとオートコンプリートが走りますので、この API が検索する内容がよく分からなくても動きは分かると思います。オートコンプリート部分が "検索ワード" で結果のリストが [検索結果], となっているイメージです。
Lambda 上で動作するソースコードイメージ
import * as common from "../common";
// (でかい)辞書 JSON import
import whatsnewj from "../json/whatsnewj.json";

exports.handler = async (event) => {
  let answer = [];
  let query = event.queryStringParameters.q;
  if(whatsnewj[query]) {
    answer = whatsnewj[query]; // 検索(これだけ)
  }
  return {
    statusCode: 200,
    headers: common.jsonHeader,
    body: JSON.stringify(answer)
  }
};
Lambda のインスタンス
Netlify Functions から起動する Lambda のインスタンスは一定の時間起動し続け、(無料枠では?)ひとつのインスタンスに固定されていそう。ファイルシステムとして /tmp を使うことも可能。もちろんアルゴリズムとしてはステートの性質をあてにしてはならない。
インスタンス数については、開発中にプログラムを変更するも新旧のプログラムが交互に値を返してくるような挙動を何度か見せて最初デバッグで混乱しました。
CDN のキャッシュなのかインスタンスが 2つ起動したのか判断がしにくかったのですが、http header の age の値が 1〜2 (秒) となっていて、またURL に影響のないユニークな引数をつけても同様の結果でしたので、古いインスタンスが残ったように見えました。何度かデプロイをしていると消えるような気がします。
本検索 API は、いまや世界中のありとあやゆる機械をエミュレートするに至った「MAME」という歴史の長いエミュレーターソフトウェアのリリースノートテキストファイル(.txt)日本語版を形態素解析し全文検索します。コードネームは mametan と名付けました。
テキストデータの元となっているのは、20年に渡り MAME 文書の日本語翻訳しておられます、MAME E2J さんの翻訳テキストファイルで大変貴重な情報です。
Netlify Functions のデプロイの仕組み
Netlify はプロジェクトのルートに配置された、netlify.toml を認識してサイトのビルドを行います。 以下がこのプロジェクトで使った設定の一部です。
[build]
publish = "generator/public"
functions = "dist/api"
command = "npm run build"
publish が通常のウェブサイトのコンテントルート(今回の API では未使用)で、functions が Lambda に配置する JavaScript を配置するディレクトリです。 1 JavaScript が 1エンドポイントになります。
今回の dist/api の配下は次のようになっていて、それぞれのファイル名が /.netlify/functions/ファイル名 という形式でエンドポイント URL となります。
mametan.js // 検索ワード返却 API
whatsnewj.js // 検索結果返却 API
release.js // リリース日返却 API
というわけで、Netlify Functions ビルド的には netlify.toem に指定した functions キーのディレクトリに AWS Lambda 形式の JavaScript を配置すれば良いだけということになります。
netlify.toem の command キーは Netlify サイトデプロイ時に Netlify 上で自動的に実行されるコマンドを書くことができます。
典型的には AWS Lambda をかくためには、npm パッケージや webpack のバンドルを活用することになると思いますので、command は npm run build などのビルドスクリプトを指定することになると思います。
Netlify 上のビルドで使えるコマンド
command や npm の script キー内で UNIX のコマンドを使うことができる。 cp や tar などが利用可能であるため比較的自由にビルドを組める。
パッケージの追加はできないと思われる(未確認)が、スタティックサイトジェネレートで使われる zola や ruby や node などなどが事前に導入済みで netlify.toml でバージョン指定が可能。Netlify 管理画面の Deploy log から見ると分かりやすい。
要はなんらかの形でファイルが publish や functions に入ればそれぞれにデプロイされる。
Functions の URL マッピング
標準のままであると URL のエンドポイントが /.netlify/functions/ファイル名 と長くなってしまうので netlify.toml で /v1/ファイル名/ 形式に rewrite しています。
redirects で status = 200 を設定すると rewrite になるようです。
[[redirects]]
    from = "/v1/*"
    to = "/.netlify/functions/:splat"
    status = 200
    force = true

[[redirects]]
    from = "/v1/whatsnewj/ja/*"
    to = "/.netlify/functions/whatsnewj?q=:splat"
    status = 200
    force = true
ただ、/v1/* と /v1/whatsnewj/ja/* のような URL を重ねるような設定はうまく効かないみたいです。何か間違ってるかな。。要調査。
追記。どうも from から to にクエリーが渡ってこないようなので event.path から取得できる関数をつくって対応しています。
/**
 * parseQueryArgs
 *
 * Workaround Netlify args perser.
 * https://community.netlify.com/t/querystringparameters-not-working-with-redirect-on-production/3828
 *
 * @param {String} rewriteUrl
 * @param {Object} queryString
 * @param {String} path
 * @param {Object} format
 * @returns {Object} extract args
 */
export function parseQueryArgs(rewriteUrl, queryString, urlpath, format) {
    let parse = Path.createPath(rewriteUrl).test(urlpath);

    // extract args
    let result = {};
    for(const key in format) {
        if(parse && parse[key]) {
            // clean url
            result[key] = parse[key];
        } else if(!netlify && queryString[key]) {
            // local query string
            result[key] = queryString[key];
        } else {
            // default value
            result[key] = format[key]
        }
    }

    return result;
}
netlify-lambda
というわけで .js をビルドして functions に指定したディレクトリに入れれば Lambda が動き出すわけですが、そもそもビルドをつくるのが大変だったり、ローカルでも動かしたりしたいというわけで、Netlify さんが netlify-lambda という便利な npm パッケージを準備してくれています。
というわけで、プロジェクトの package.json に記載する内容は次のような形になります。
{
  "name": "e2j-api",
  "version": "0.1.0",
  "scripts": {
    "devel": "netlify-lambda --timeout 20 --config ./webpack.functions.js serve script/api/endpoint",
    "build": "netlify-lambda --config ./webpack.functions.js build script/api/endpoint"
  },
  "dependencies": {
    "axios": "^0.19.2",
    "decompress": "^4.2.0",
    "decompress-tarbz2": "^4.1.1"
  },
  "devDependencies": {
    "netlify-lambda": "^1.6.3"
  }
}
devDependencies として netlify-lambda を入れることにより netlify-lambda コマンドを準備し、script のキーのところでコマンドを呼び出しビルドしています。dependencies では自分のプログラムで利用するパッケージが指定できます。
netlify-lambda の webpack 設定
netlify-lambda コマンドでは --config ./webpack.functions.js オプションでビルドで使われている webpack.config.js への追加設定が可能(なお netlify-lambda コマンドのソースからビルドで動作する webpack config が参照できる)
このプロジェクトでは、Lambda プログラムに対してミニマイズしても意味がないという理由で optimization: { minimize: false } を追加指定。
// webpack.functions.js
module.exports = {
  optimization: { minimize: false },
};
しかも、今回の場合巨大な 100M 超え .json を次のように webpack で import しているため、、
/**
 * e2j whatsnewj API
 */
import * as common from "../common";
// (でかい 100MB)辞書 JSON import
import whatsnewj from "../json/whatsnewj.json";
ミニマイズ時に JS のパーサーがダウンしてしまうという凄惨な事故が起きたため必須設定となっております。。
netlify-lambda の webpack や babel のバージョン
この辺から使われる webpack や babel などのバージョンを知ることができます。ビルドを修正したい場合は、このリポジトリをフォークして変更。自分の package.json にてそのフォークしたリポジトリーを使うようにすると簡単かも知れません。
{
  // ....
  "devDependencies": {
    // "netlify-lambda": "^1.6.3"
    "netlify-lambda": "git+https://github.com/h1romas4/netlify-lambda"
  }
}
Netlify Functions の性能リミット
というわけで、当初 120M を超える .json を抱えた .js を Netlify Functions に載せ恐る恐る動かした所… 10.01sec timeout という悲しいメッセージが…
- でっかい .json を webpack で固めたものは Lambda 上でもそもそもパースに時間がかかる。これは webpack v4.35.3 でかなり高速化されているようです。ちなみに netlify-lambda のデフォルト webpack は現在
package-lock.jsonなしの^4.17.1指定。 - AWS Lambda のデフォルト nodejs は 10 系。
netlify.tomlのAWS_LAMBDA_JS_RUNTIMEでより高速になった 12系に変更可能。 - あと辞書を 100MB ほどに縮小
いろいろ試した見たところ無事メモリー 522MB の Init Duration 6.9 秒で初期起動成功。
8:20:30 PM: 2020-03-27T11:20:30.079Z	5b35fc60-b9f0-4a43-a642-38a6764950a7	INFO	q=test
8:20:30 PM: Duration: 3.22 ms	Memory Usage: 522 MB	Init Duration: 6934.64 ms
初回以降は、
8:22:08 PM: 2020-03-27T11:22:08.133Z 0b548212-c6b6-4621-b0ec-75747a9dff1a INFO q=麻雀
8:22:08 PM: Duration: 331.08 ms Memory Usage: 522 MB 8:22:53 PM: 2020-03-27T11:22:53.071Z ee639944-7168-4c74-8240-3630fba6da89 INFO q=麻雀
8:22:53 PM: Duration: 2.83 ms Memory Usage: 522 MB
一度目の検索ワード「麻雀」でのアクセスが 331ms で、同じ検索ワードだと 2.83ms ということで CDN? キャッシュ? が効いたのかな…?という感じの思ったとおりの動きになってくれました。
おそらく .json のサイズ感としてはこれくらいが限界の印象です。今回はこれで 20年分のデータとなっていますので、あと 10 年位動くかな。。よぼよぼ。。
Netlify のネットワーク帯域
実は当初、辞書のデーターはこのような .json を import する無理な方法は採らず、JavaScritp の配置したキャッシュ変数が空なら、 http リクエストで自身のコンテントルートに配置した .json や .bz2 ファイルをネットワークから取得してキャッシュ変数にロードしようと考えていました。
/**
 * response cache on AWS Lambda
 */
let jsonCache = {};

/**
 * async http request
 *
 * @param url
 * @return JSON
 */
export async function getJsonHttp(url) {
  if(url in jsonCache) return jsonCache[url];
  try {
    if(url.match(/^.+\.tar\.bz2$/)) {
      // for .tar.bz2 arcive
      const res = await axios.get(url, { responseType: "arraybuffer" });
      const filename = crypto.createHash('sha1').update(url).digest('hex');
      const tar = "/tmp/" + filename + ".tar.bz2";
      await fsp.writeFile(tar, res.data);
      let ret = await decompress(tar, null, { plugins: [ decompressTarBz2() ] });
      let whatsnewjson = JSON.parse(ret[0].data.toString('utf-8'));
      await fsp.unlink(tar);
      jsonCache[url] = whatsnewjson;
    } else {
      // for plane json
      const res = await axios.get(url);
      jsonCache[url] = res.data;
    }
    return jsonCache[url];
  } catch (error) {
    console.log(error);
    throw Error(error);
  }
}
.bz2 圧縮であればファイルサイズは 10MB 程度になっていまいたので、同じ AWS 内の通信なので間に合うかなという皮算用でしたが残念ながら間に合わずあえなく断念。
1MB 未満の小さな .bz2 ファイルや .json であれば時間内に動作しロードすることができました。あまり関係ないですが decompress-tarbz2 は WebAssembly で動作しているようでプラットフォームを選ばず高速に動作することを確認。 decompress-tarxz はネイティブを呼んでる模様。
Netlify 外の仕組みになってしまいますが、自前の S3 などにファイルを配置して aws-sdk で取り出すと巨大なデーターのロードもすんなりいくのかもしれません(未確認)
リクエスト回数・時間制限
Netlify Functions 無料枠には API 12,500 回リクエスト、処理時間 100時間の制限があります。
二晩くらい API たたいてテストしていた気がしますが、大人気 API にでもならない限り制限にかかることはなさそうです。 😀
Counts every time a function was invoked in the current billing period.
832/125,000
124,168 requests left

Run time Combined run time of all function requests in the current billing period.
15 minutes/100 hours
100 hours left
終わりに
というわけで、API としては無茶方式のサンプルになってしまいましたが、内容中に何か役立つ知見があったら幸いです。
この作業のきっかけとなりました、20年に渡り MAME 文書の翻訳をされている MAME E2J さんに感謝です。ちなみに先日サイトを WordPress でリビルドされておりアーカイブが大変見やすくなっていますので、お好きな方はぜひ。
MAME E2J
a bridge across cultures
最後にソースファイルへのリンクを貼っておきます!
Github Actions による形態素解析 & Netlify Lambda プロジェクト
Vue の API テスト用画面